看大肥鱼或者一些长思维链模型推理时,经常能观察到类似轻度多动症的生成特征:思维不断发散、自我怀疑、推翻前文、跳出当前分支,转了一大圈之后再折返回来,甚至会进行无关的操作,例如:
在某些规则明确、需要按部就班推进的工作流任务中,这种自回归过程会出现一种让人在意的偏差。比如一个有先后依赖关系的流程,模型前面几步都按规矩推导完了。在推理文本的最后几句,它明确写道:“前序项均已记录,尚缺最终确认步骤”。按照规则,下一步显然应该继续推进。但在紧接着的动作生成位置,模型输出了一个简短的终止 STOP。
在普通聊天中,这可能只是一次无伤大雅的敷衍;但在需要实际调用工具或闭环执行的自动化系统里,整个任务就在终点前停住了。这引出一个很具体的机制问题:当模型给出错误动作时,是它内部的隐状态彻底把进度算糊涂了,还是状态信息一直清晰存在,仅仅是通往动作决策的最后一环发生了偏离?
遮蔽记忆会徒增错误
Yann Lecun说过,思维链本质上是重要的事情说三遍,模型就像一个不断回头读自己草稿纸的人。自回归模型每生成一个新词,都要把前面生成的所有文字作为上下文重新算一遍。如果它之前已经写出了一段走入死胡同的推导,它会不会因为反复读到自己的错误文字,被这种上文依赖拖着越陷越深?
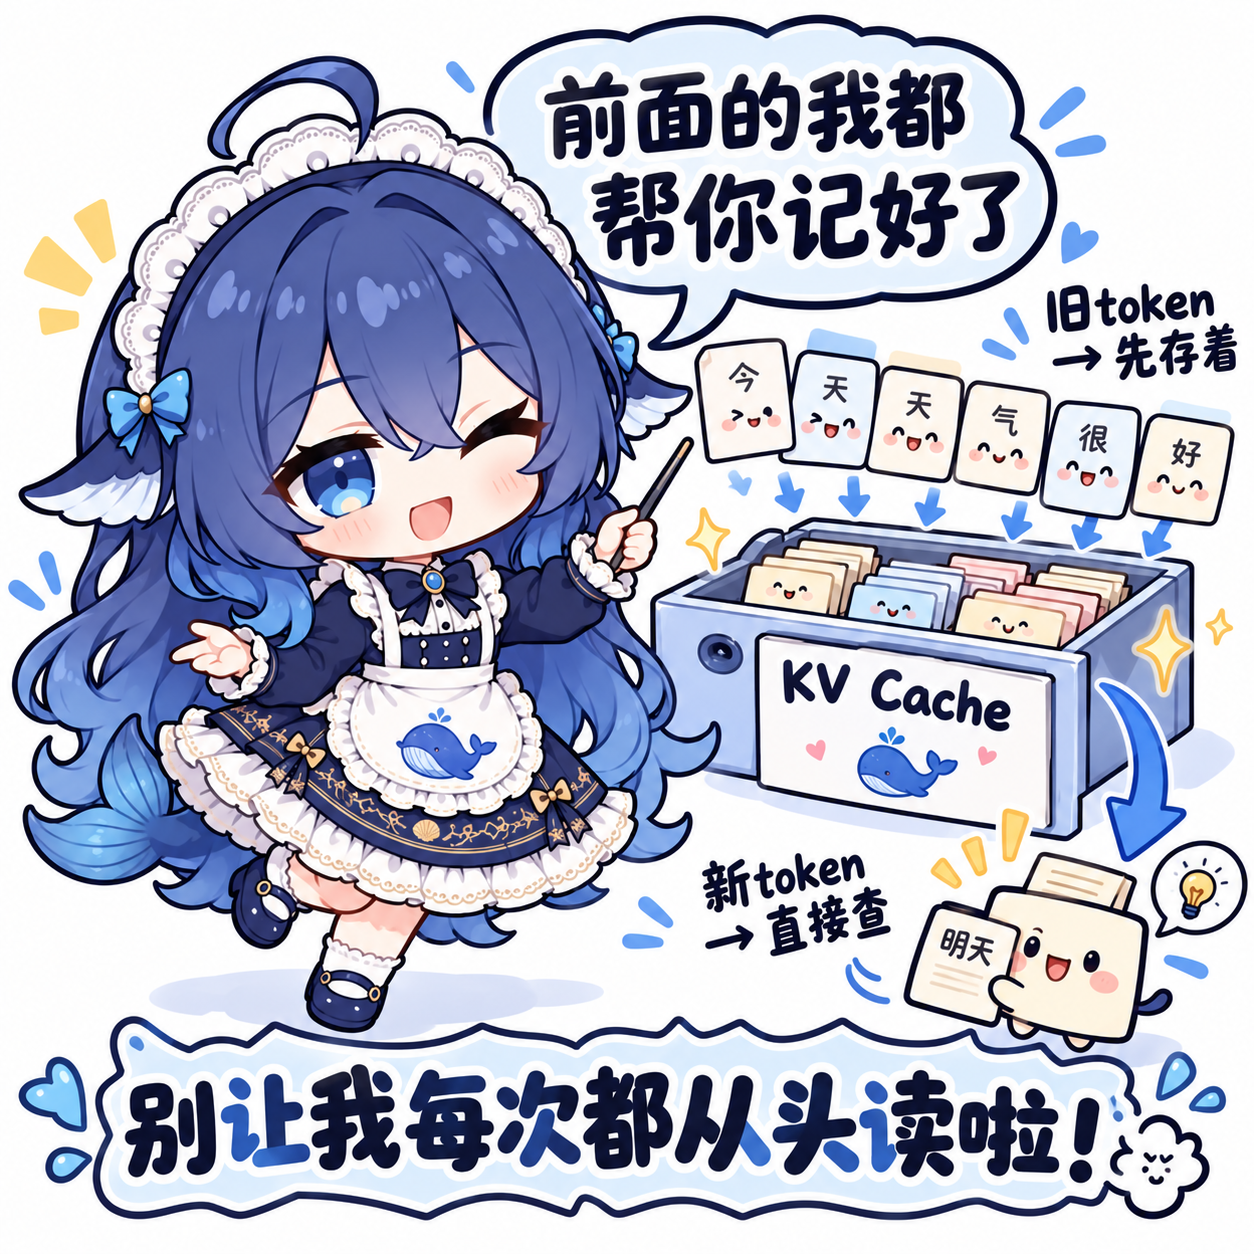
这里涉及推理时的一个底层机制: K/V 缓存(Key/Value Cache)。简单来说,Transformer 在逐字生成时,不需要每次都把历史文本从头计算一遍,而是会把之前每个词计算出来的键(Key)和值(Value)向量存在缓存里供后续注意力机制读取。所谓“遮蔽(Mask)某段位置的 K/V 缓存”,粗略理解,就是在模型计算下一个词时,切断它对这部分历史文字的读取通道,让它看不见自己刚才犯的错。在程序验证合法性的路径搜索任务上,我试图测试这种记忆抹除干预。如果这个直觉成立,纠偏的手段应该很直接:把这部分错误历史从模型的记忆中抹除掉。
但数据并没有支持最初的直觉:
- 屏蔽错误路线节点的 K/V 缓存后,模型在两步内纠偏并恢复正确的概率只有 13.5%;而在对照组中,屏蔽等量中性位置的 K/V 缓存,恢复率反而有 31.1%。
- 更明显的现象是所谓的“错误重放(Replay)”:在错误记忆被屏蔽后,模型虽然在文本里写了
REVISE(我要修正),随后却把刚刚那条错误的路线又重新生成了一遍。这种原地打转的概率高达 64.9%,而中性对照组只有 2.7%。
在注意力机制里,一段路径被程序判定为错误,它在上下文里也应当扮演着“排除项”的角色,它至少记录了错题。一旦直接把这块记忆拿掉,模型失去了用于对比的负向参照,反而更容易重新踩进同样的坑里。
状态可读性与动作选择的分离
既然不能简单归咎于“被错误记忆拖住”,那在模型生成错误动作的瞬间,它内部究竟清不清楚当前的任务状态?
为了回答这个问题,我们需要用到可解释性研究里常用的工具:线性探针(Linear Probe)。
深层神经网络的残差流(激活向量)类似一张高维投影。我们用探针去给模型的某一层激活向量做体检,看能不能从中线性解码出外部真实世界的信息。因此,接下来使用常用的业务工作流任务中构建了测试集。在收集到的一批自然推理轨迹中,模型出现的动作错误形式高度统一:流程合规且未完成,但模型输出了 STOP。
我们在输出最终动作的那一刻,用预先训练好并冻结权重的探针去检测深层激活:无论是在中间特征层还是更靠近输出的深层,探针将这些错误轨迹准确识别为“未完成”的比例都在 90% 以上。
这说明,即使模型输出了提前终止的动作,其深层网络中关于任务完成状态的表征并没有丢失或混淆。它清楚地保留着任务未完的信号,但后续选择动作时,却走向了相反的一面。
随后我们测试了外部文本干预:保持输入的问题不变,仅把模型自然写出的推理文本换掉。无论是按事实重写、还是换成仅标注状态的简短符号,甚至是长度完全相同的等长中性废话,原本走向提前终止的轨迹在后续动作位置上全部纠偏回了 CONTINUE。等长中性文本同样有效,说明这并不是上下文变短带来的简单干扰。模型在自言自语中写下的那些收尾式自然语言,对动作预测施加了直接的方向性影响。
组件激活补丁的非对称表现
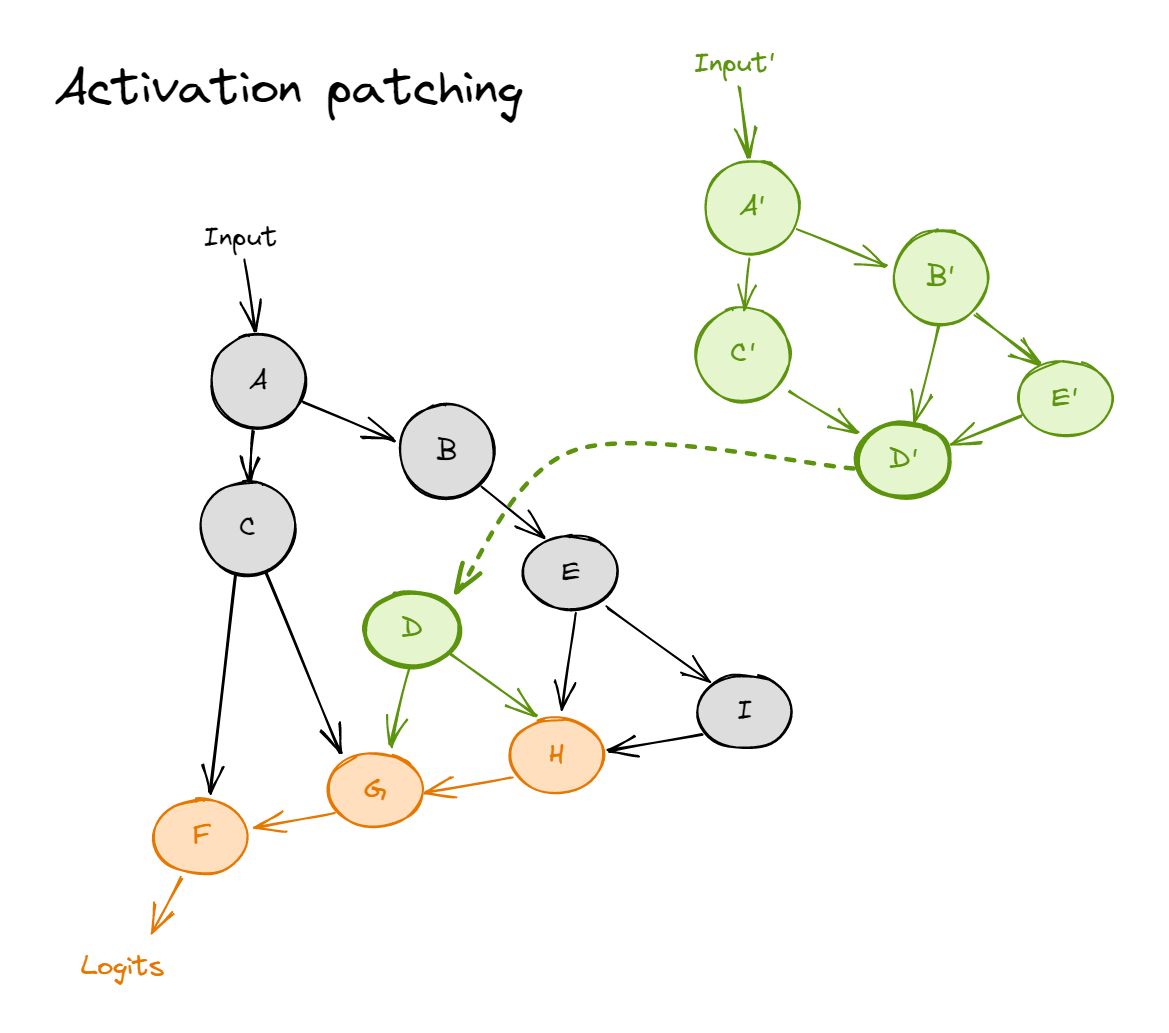
语言表面的文本可以替换,模型内部的计算流也可以做局部的置换。
这里使用了激活补丁(Activation Patching)技术。我们可以找两组同一提示下生成的轨迹,一组正确(选择了 CONTINUE),一组错误(提前 STOP)。而后,在生成动作的时刻把错误轨迹里某个模块的计算结果掏出来,精确覆盖到正确轨迹的对应位置上,观察输出动作会不会被带偏;反过来,再试着用正确的组件输出去拯救错误轨迹。
在数十组自然分歧的轨迹对中,实验呈现出两处很有意思的特征:
第一是功能分工的分离:
干预深层的前馈网络时,末层的状态探针读数会发生明显变化,说明该组件与底层状态认知紧密绑定。但如果干预的是某个注意力机制组件,末层探针的读数几乎未受影响,但选择 STOP 动作的概率却出现了明显提升。这个注意力组件在几乎不改变线性状态读出的同时,直接推动了动作的改变。
这意味着大肥鱼属于是依然知道任务没做完但是就是莫名其妙不做了。
第二是方向上的不对称性:
把错误轨迹的注意力激活写入正确轨迹,有相当比例的样本直接翻转了动作预测,导致提前终止;但反过来,把正确轨迹的激活写入错误轨迹时,成功纠偏的比例极低,动作概率的偏移也微乎其微。 内部组件对动作的影响主要表现为单向的终止偏置,一旦进入提前结束的计算路径,很难通过单个组件的局部置换来实现逆转。
对于大肥鱼来说,只要有白饭突然在它眼前晃一下,它就很容易被带偏;可一旦它脑子里已经认定今天到此为止、准备睡大觉,就算x在旁边大声敲钟、给它植入一段正确记忆,它也很难重新打起精神。内部组件在动作决策上的影响体现为,它极容易被触发走神,却很难在收工的状态下被单点拉回。
奖励机制对策略的塑造
这种动作偏置是如何形成的?它是否可能与后训练阶段(强化学习)的目标引导有关?
在受控环境下,我们在小参数量基座模型上测试了强化学习奖励对动作策略的塑造作用。
为了观察纯粹的动作策略变化,我们先让模型具备充分的状态读取能力,随后在显式提供状态提示的前提下训练动作分支:一组仅对正确动作给予奖励,另一组在此基础上对继续执行的动作给予微小加分。
结果很直接:额外获得继续奖励的分支,在状态依然能清晰判别任务是否完成的前提下,选择继续执行的概率大幅提升,即使任务已经完成也倾向于多推一步。这种偏置在训练完全未见的新领域上也得到了复现。
这表明,改变奖励设计完全可以在不损伤底层状态认知的前提下,独立塑造出一套脱节的动作策略。但这一结论严格属于受控环境下的因果验证,大模型在自然状态下表现出的提前终止,究竟是在长思考数据的蒸馏中习得的,还是对齐训练带来的副产物,依然有待进一步厘清。
大肥鱼参与
感谢梁圣开源的版本。感谢大肥鱼形象创作者 ZipZipPipe。